أظهرت أبحاث جديدة من جامعة برينستون أن فريقًا من وكلاء الذكاء الاصطناعي المتخصصين والمنظمين جيدًا يمكن أن يتفوق على نموذج كبير واحد. قام الباحثون بدمج وكلاء متخصصين بشكل ضيق، تم إنشاؤهم بشكل مستقل من قبل مطورين مختلفين، وحقق نظامهم دقة حوالي 70٪ في معايير معقدة في مهام هندسة البرمجيات والتفكير.
هذا الأمر ذو أهمية في ظل سباق الحصول على أفضل وكلاء الذكاء الاصطناعي: تتنافس OpenAI وAnthropic وGoogle DeepMind بنشاط في الأداء. يمكن أن يغير الاستنتاج لصالح التنسيق على الحجم قواعد هذا السباق.
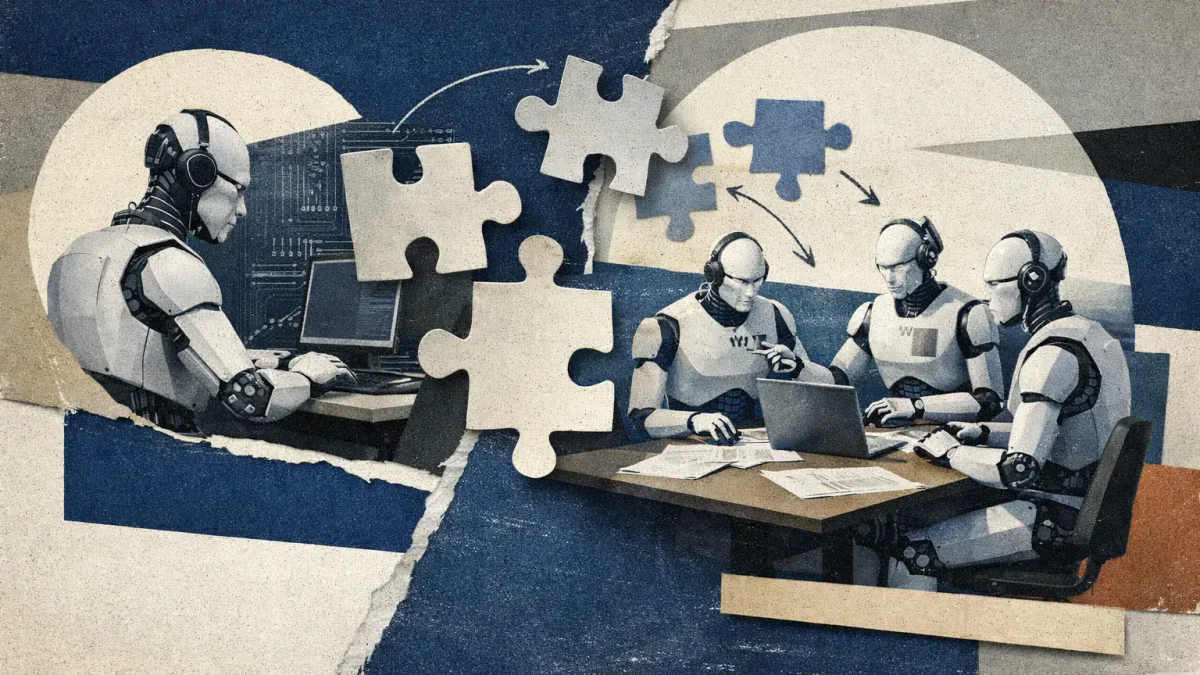
في جوهر الأمر هو مفهوم "سوق الوكلاء". يقترح المؤلفون تشبيهًا مع مستشفى: بدلاً من أن يتولى طبيب عام واحد كل شيء، هناك طبيب قلب، وأخصائي أشعة، وجراح، كل منهم يركز على مهمة محددة. في نظام برينستون، يتم تخصيص الوكلاء الفرعيين لمجالات محددة، ويتم تطويرهم بشكل منفصل، ثم يعملون معًا على حل المشكلات المعقدة. المبدأ بسيط: التخصص بالإضافة إلى التركيب يتفوق على التعميم على نطاق واسع.
تم الحصول على الرقم الرئيسي على إطار عمل SWE-bench، وهو إطار يختبر مدى جودة تعامل الذكاء الاصطناعي مع مهام هندسة البرمجيات. تعني دقة حوالي 70٪ أن النظام نجح في حل حوالي سبع من كل عشر مهام معقدة.
يعتمد النهج على فكرتين مألوفتين: التعلم الجماعي، حيث يكون الحكم الجماعي لعدة نماذج أقوى من أي نموذج فردي، وهندسة الخدمات المصغرة، حيث يتم تقسيم تطبيق كبير إلى خدمات صغيرة مستقلة، كل منها يؤدي شيئًا واحدًا بشكل جيد. تطبق برينستون هذه المبادئ على الوكلاء المستقلين على نماذج اللغة. يعتمد العمل على مشروع برينستون السابق، SWE-agent، الذي سمح لنماذج اللغة بالعمل كوكلاء في هندسة البرمجيات؛ توسع البحث الجديد من وكيل واحد إلى فريق منسق.
الاستنتاج الأكثر إلحاحًا هو معماري. إذا كان التخصص والتركيب يتفوقان بالفعل على الوكيل العام، فإن السؤال للمطورين يتغير: ليس "كيف نجعل النموذج أكبر"، بل "كيف ندمج الأجزاء الصحيحة". تظهر تحديات تصميم جديدة: أي الوكلاء يتم استدعاؤهم، كيف يشاركون السياق، كيف يتم دمج نتائجهم.
أُعدت هذه المادة لأغراض معلوماتية وتعريفية فقط ولا تشكل نصيحة أو توصية مالية.
مقالات ذات صلة