프린스턴의 새로운 연구에 따르면, 잘 조직된 전문 AI 에이전트 팀이 단일 대형 모델보다 더 우수한 성능을 발휘할 수 있습니다. 연구자들은 서로 다른 개발자들이 독립적으로 만든 좁게 전문화된 에이전트를 결합하여 소프트웨어 엔지니어링 및 추론 작업에서 약 70%의 정확도를 달성했습니다.
이는 최고의 AI 에이전트를 위한 경쟁의 배경에서 중요한 의미를 가집니다: OpenAI, Anthropic, Google DeepMind가 성능 면에서 적극적으로 경쟁하고 있습니다. 규모보다 조정에 유리한 결론은 이 경쟁의 규칙을 바꿀 수 있습니다.
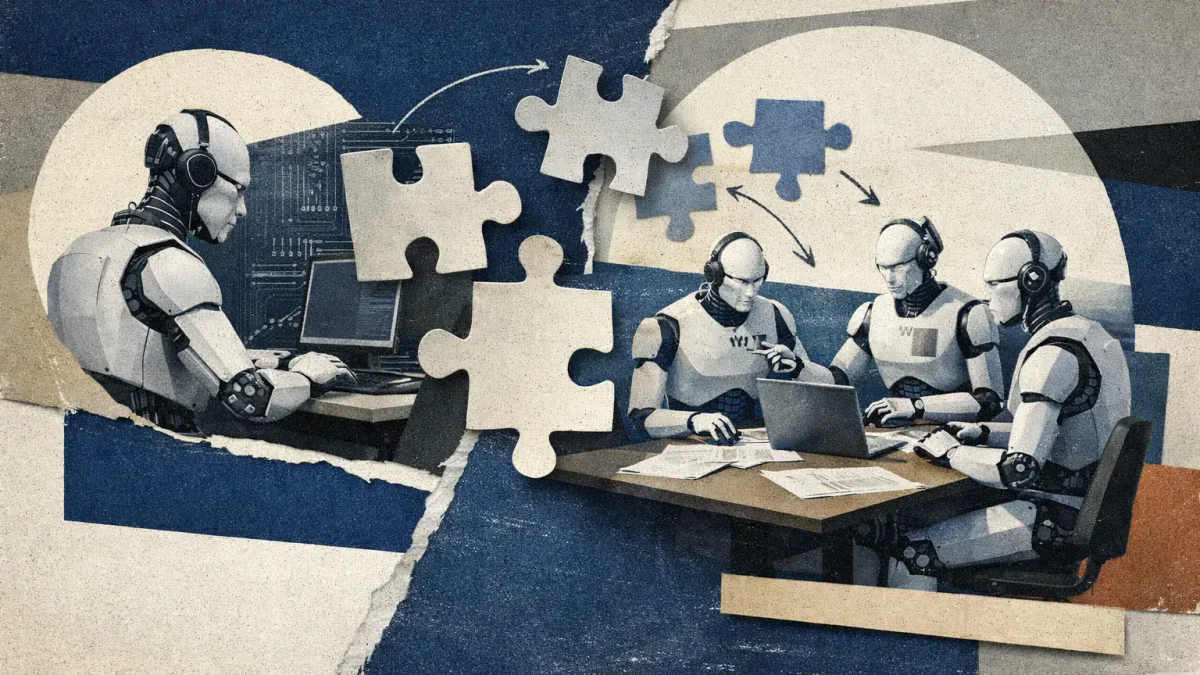
핵심은 "에이전트 시장"이라는 개념입니다. 저자들은 병원과의 유사성을 제안합니다: 모든 것을 처리하는 일반 의사 대신, 심장 전문의, 방사선 전문의, 외과의가 각각 특정 작업에 집중합니다. 프린스턴 시스템에서는 하위 에이전트가 특정 도메인에 맞춰 개발되고, 복잡한 문제를 함께 해결합니다. 원칙은 간단합니다: 전문화와 조합이 규모의 일반화를 능가합니다.
핵심 수치는 AI가 소프트웨어 엔지니어링 작업을 얼마나 잘 처리하는지를 테스트하는 SWE-bench에서 얻어졌습니다. 약 70%의 정확도는 시스템이 약 10개의 복잡한 작업 중 7개를 성공적으로 해결했음을 의미합니다.
이 접근법은 두 가지 익숙한 아이디어에 의존합니다: 여러 모델의 집단적 판단이 단일 모델보다 강력한 앙상블 학습과, 큰 애플리케이션을 각각 하나의 일을 잘하는 작은 독립 서비스로 나누는 마이크로서비스 아키텍처입니다. 프린스턴은 이러한 원칙을 언어 모델의 자율 에이전트에 적용합니다. 이 작업은 소프트웨어 엔지니어링에서 에이전트로서 언어 모델을 허용한 이전 프린스턴 프로젝트 SWE-agent에 기반을 두고 있으며, 새로운 연구는 이를 단일 에이전트에서 조정된 팀으로 확장합니다.
가장 즉각적인 교훈은 아키텍처적입니다. 전문화와 조합이 보편적 에이전트를 능가한다면, 개발자에게 중요한 질문은 "모델을 어떻게 더 크게 만들 것인가"가 아니라 "어떻게 적절한 부분을 결합할 것인가"로 바뀝니다. 새로운 설계 과제가 등장합니다: 어떤 에이전트를 호출할지, 어떻게 컨텍스트를 공유할지, 결과를 어떻게 결합할지.
이 자료는 정보 제공 목적으로만 작성되었으며 재무 자문이나 권장 사항을 구성하지 않습니다.
관련 도움말