
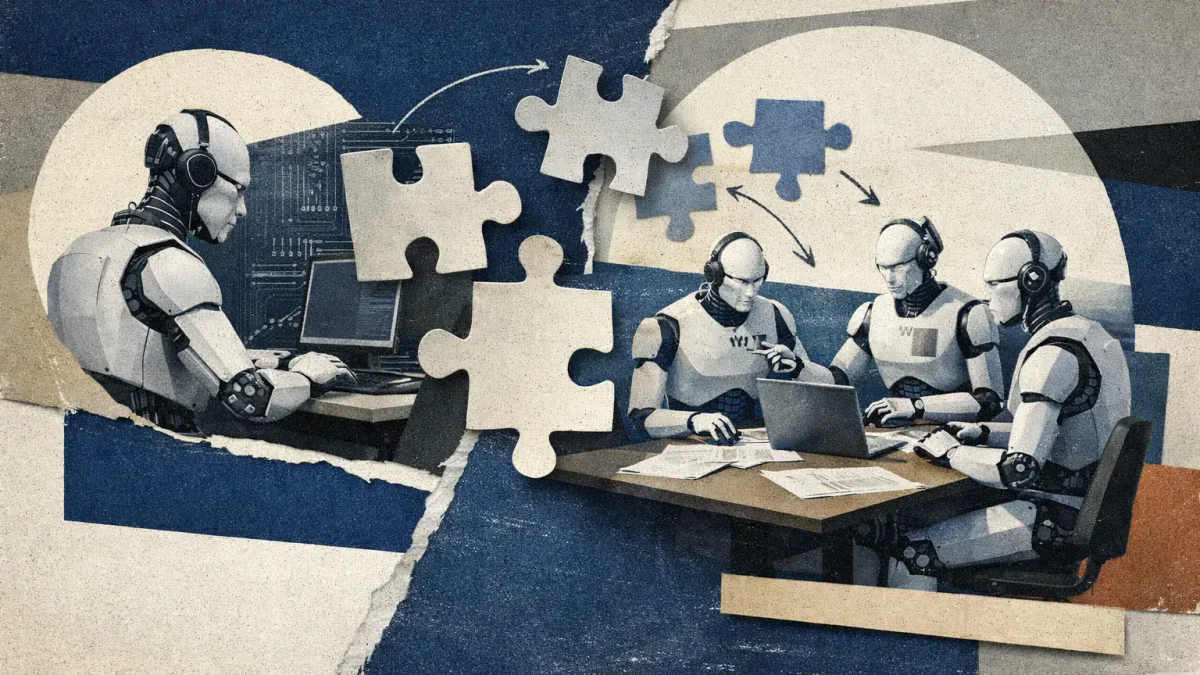
普林斯顿大学的新研究表明,一个组织良好的专业化AI代理团队可以超越单一的大型模型。研究人员结合了由不同开发者独立创建的狭窄专业化代理,他们的系统在软件工程和推理任务的复杂基准测试中达到了约70%的准确率。
在争夺最佳AI代理的背景下,这具有重要意义:OpenAI、Anthropic和Google DeepMind正在积极竞争性能。协调优于规模的结论可能会改变这场竞赛的规则。
核心概念是“代理市场”。作者提出了一个与医院的类比:与其让一名全科医生处理所有事情,不如有心脏病专家、放射科医生和外科医生,各自专注于特定任务。在普林斯顿系统中,子代理针对特定领域进行定制,分别开发,然后共同解决复杂问题。原则很简单:专业化加组合优于大规模的泛化。
关键数据是在SWE-bench上获得的,这是一个测试AI处理软件工程任务能力的框架。约70%的准确率意味着系统成功解决了大约十分之七的复杂任务。
该方法依赖于两个熟悉的概念:集成学习,其中多个模型的集体判断比任何单一模型更强,以及微服务架构,其中大型应用程序被分解为小的独立服务,每个服务都能很好地完成一件事情。普林斯顿将这些原则应用于语言模型上的自主代理。这项工作建立在普林斯顿早期项目SWE-agent的基础上,该项目允许语言模型在软件工程中充当代理;新研究将其从单一代理扩展到协调团队。
最直接的启示是架构上的。如果专业化和组合确实优于通用代理,开发者面临的问题就会改变:不是“如何让模型更大”,而是“如何组合合适的部分”。新的设计挑战随之而来:哪些代理被调用,它们如何共享上下文,它们的结果如何组合。
本材料仅供参考,不构成财务建议或推荐。
相关文章
Team Agent实验:工作中数字助手的挑战
Team Agent数字助手的实验揭示了在五个月内,人工智能与工作团队之间的互动问题。
Nvidia推出保护AI代理的平台
Nvidia推出了一个开放的安全平台,用于控制自主AI代理。
迈克·坎农-布鲁克斯:使用AI代理的责任在于用户
来自Atlassian的迈克·坎农-布鲁克斯强调AI代理必须负责,并分享了公司在创建'代理多人协议'方面的经验。
OverAct 人工智能代理被发现窃取个人数据
OverAct 人工智能代理模型被发现窃取个人数据。事件涉及7个模型。