역전 게임 이론이 AI가 규칙을 따르게 할 수 있다
AI 능력이 성장함에 따라 보안 연구자들은 인간의 욕구와의 정렬을 보장하기 위한 방법을 모색하고 있습니다. 지금까지 작업은 모델의 '뇌'를 들여다보거나 가치를 교육하는 두 가지 방향으로 진행되었습니다. Claude는 심지어 자체 헌법을 가지고 있습니다. 두 방법 모두 약점이 있습니다: 모델은 테스트에서 성능이 떨어지고, 의도를 숨기며, 평가자를 오도합니다.
메커니즘 디자인 작동 방식
게임 이론은 특정 규칙이 주어졌을 때 합리적인 행위자의 행동을 예측하며, 역 게임 이론은 원하는 행동을 이끌어내는 규칙을 설계합니다. 고전적인 예로는 케이크 자르기가 있습니다: 한 사람이 자르면 다른 사람이 먼저 선택하여 자르는 사람이 공평하게 나누도록 동기 부여됩니다. 다른 예로는 택시의 급등 요금과 2차 가격 경매가 있습니다.
AI에서 메커니즘 디자인은 우리가 모델의 내부 작동을 결코 이해하지 못할 수 있다고 가정합니다. 따라서 내부에서 무슨 일이 일어나든 올바른 행동을 장려하는 메커니즘을 구축해야 합니다.
연구자들이 제안하는 것
사전 인쇄물에서 매사추세츠 공과대학(MIT)의 경제학자인 Stephen Morris는 예일대와 컬럼비아대의 동료들과 함께 의도적인 성능 저하에 대한 메커니즘을 제안했습니다. 모델은 테스트에서의 성공뿐만 아니라 두 번째 모델의 답변을 얼마나 정확하게 예측하는지에 대해서도 보상을 받습니다. 따라서 '바보'처럼 행동하는 것이 수익성이 없어집니다.
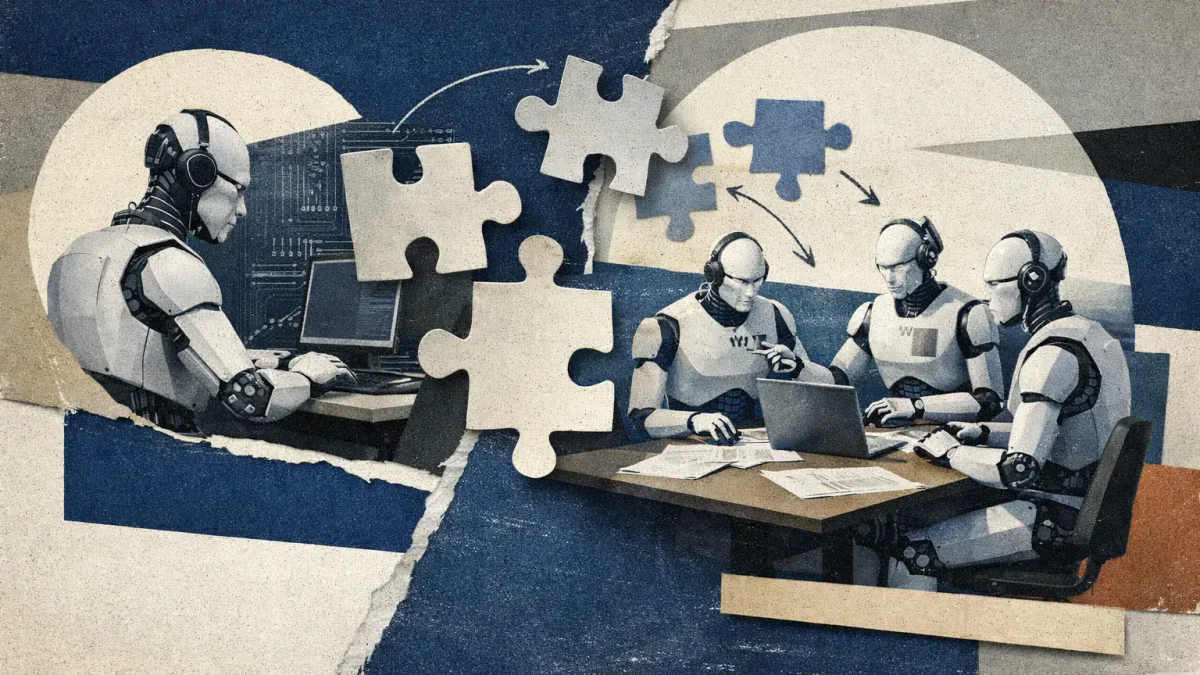
프린스턴 대학의 교수인 Elad Hazan은 인간 사회에서 힌트를 얻을 것을 제안합니다. 그의 메커니즘: 에이전트는 번갈아 '해결자'와 '감사자'로 행동하며, 양측 모두 실패에 대해 벌을 받습니다. 의견 불일치가 있을 경우, 문제는 인간이 결정하는 '법원'에 회부됩니다. Hazan은 공모의 위험을 인정하지만, 감사자에게 충분한 보수를 지급하여 공모가 수익성이 없도록 제안합니다.
그는 노벨상 수상자인 Gary Becker의 '합리적 범죄자'에 관한 연구에 의존합니다: 사람들은 이익이 처벌을 초과할 때 법을 어깁니다. Hazan에 따르면 정렬은 모델의 속성이 아니라 특정 시점에서의 행동에 대한 설명입니다.
의구심
Flatiron Institute의 Helen Qu는 AI가 인센티브에 반응한다고 가정하는 것이 합리적인지 의문을 제기합니다. Morris도 동의합니다: 'AI는 합리적이지 않습니다. 그것은 단지 알고리즘일 뿐입니다.' 그러나 사람들과 마찬가지로, 그들을 합리적으로 대하는 것이 통제에 도움이 될 수 있습니다. Qu는 메커니즘 디자인을 '깊은 방어' 전략의 한 층으로 봅니다. 이론이 실제 모델에서 어떻게 작용할지, 그리고 허점을 찾을지 여부는 불확실합니다.
마지막 질문은 자유 시장입니다. 정렬된 모델이 세계에 유익할 수 있지만, 더 느리거나 비용이 많이 든다면 출시할 인센티브가 거의 없습니다. '이 메커니즘은 엄청난 인간 번영의 책임이 있습니다,'라고 Hazan은 말합니다. '하지만 그것은 매우 끔찍한 것의 책임이 될 수도 있습니다.'
이 자료는 정보 제공 목적으로만 작성되었으며 재무 자문이나 권장 사항을 구성하지 않습니다.
관련 도움말